
随着互联网的发展,数据的产生量越来越大,数据分析和处理也成为了企业发展的重要环节。传统的数据处理方式已经无法满足现代企业的需求,而实时数据流处理和分析则成为了解决方案之一。本文将介绍如何使用Linux进行实时数据流处理和分析,其中包括Apache Kafka和Apache Flink的使用。
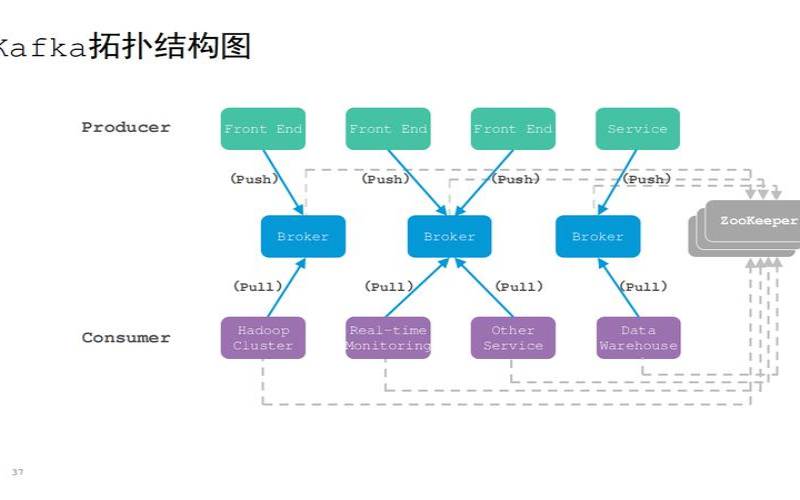
Apache Kafka是一个分布式的流处理平台,可以处理实时数据流。它可以将不同来源的数据流进行整合,使得数据流的处理变得更加高效。Apache Kafka的主要作用是将数据流从生产者传递给消费者,同时在传递的过程中可以进行数据的转换、处理和存储。
1.1 安装和配置
首先需要在Linux系统中安装Apache Kafka,可以从官网上下载最新版本的软件包进行安装。安装完成之后,需要进行配置。配置文件位于config目录下,其中server.properties是主要的配置文件。需要配置的内容包括:
- broker.id:Kafka集群中每个节点的唯一标识符。
- listeners:Kafka集群中用于监听请求的网络接口和端口。
- zookeeper.connect:Zookeeper的连接地址和端口号。
1.2 生产者和消费者
在使用Apache Kafka进行数据流处理时,需要先创建生产者和消费者。生产者负责将数据流发送到Kafka集群中,而消费者则负责从Kafka集群中接收数据流并进行处理。
创建生产者和消费者的步骤如下:
- 创建一个Producer实例,指定ProducerConfig。
- 创建一个TopicPartition实例,指定要发送和接收的主题和分区。
- 使用send()方法向Kafka集群中发送数据流。
- 创建一个Consumer实例,指定ConsumerConfig。
- 调用subscribe()方法订阅要接收的主题。
- 使用poll()方法从Kafka集群中接收数据流。
1.3 数据流处理

- 创建一个TopologyBuilder实例,指定流处理的拓扑结构。
- 使用KStream和KTable类对数据流进行操作。
- 使用start()方法启动流处理任务。
Apache Flink是另一个流处理平台,可以进行实时数据流处理和分析。它使用流式计算模型,可以处理非常大的数据集。Apache Flink的主要作用是将数据流进行转换和分析,并将结果输出到各种数据存储系统中。
2.1 安装和配置
安装Apache Flink的方法与安装Apache Kafka类似,可以从官网上下载最新版本的软件包进行安装。安装完成之后,需要进行配置。配置文件位于conf目录下,其中flink-conf.yaml是主要的配置文件。需要配置的内容包括:
- jobmanager.rpc.address:JobManager的网络接口和端口。
- taskmanager.numberOfTaskSlots:每个TaskManager的任务槽数量。
- state.backend:用于存储流处理任务状态的后端存储。
2.2 数据流处理
在使用Apache Flink进行数据流处理时,需要使用DataStream API。DataStream API提供了一系列的操作,可以对数据流进行过滤、转换、聚合等操作。使用DataStream API进行数据流处理的步骤如下:
- 创建一个StreamExecutionEnvironment实例,指定流处理的环境。
- 使用readTextFile()方法从文件中读取数据流。
- 使用map()方法对数据流进行转换。
- 使用filter()方法对数据流进行过滤。
- 使用keyBy()方法对数据流进行分组。
- 使用window()方法对数据流进行窗口化操作。
- 使用reduce()方法对数据流进行聚合。
- 使用writeAsText()方法将结果输出到文件中。
本文介绍了如何使用Linux进行实时数据流处理和分析,其中包括Apache Kafka和Apache Flink的使用。Apache Kafka主要用于将数据流从生产者传递给消费者,并在传递的过程中进行数据的转换、处理和存储。Apache Flink主要用于将数据流进行转换和分析,并将结果输出到各种数据存储系统中。通过使用这两个流处理平台,可以使得数据流的处理变得更加高效和精确,从而提高企业的竞争力和效率。


本文来源:国外服务器--使用Linux进行实时数据流处理与分析:Apache Kafka与Apache Flink | 云服务器CVM网
本文地址:https://www.idcbaba.com/guowai/6313.html
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 1919100645@qq.com 举报,一经查实,本站将立刻删除。